新加坡服务器怎样部署多语言AI客服?金融级合规选型发生了什么变化
一个做独立站美妆出海的个人站长,去年把客服团队从深圳迁到新加坡,用 GPT-4 接口撑了半年,结果每月 API 账单比服务器还贵,而且欧盟用户的聊天记录出境问题被支付通道问询。今年 Qwen2.5-7B 开源后,他决定在新加坡自建 RAG 知识库加多语言客服。这篇文章复盘他的落地路径:花了多少钱、配了什么机器、踩了哪些坑。
为什么是新加坡,而不是直接买 API
东南亚业务总部落在新加坡,核心原因有三个:一是新加坡机房到印尼、马来西亚、越南的延迟普遍在 30~60ms,比从香港或美西转发稳定;二是新加坡 PDPA 对数据出境有明确要求,金融级客户(支付、保险、借贷)通常要求数据留在本地;三是新加坡机房普遍支持匿名购买,对个人站长和自媒体博主更友好,不需要冗长的企业实名流程。
但“合规”不是买台服务器就自动满足。金融级合规一般看三层:数据存储位置(是否在新加坡境内)、传输加密与访问审计、以及灾备与在线率承诺。前两层靠部署架构解决,第三层靠机房 SLA。秀米云新加坡节点提供 99.9% 在线率保障和 DDoS 高防,适合把对外客服入口放在这里,但内部知识库的备份仍建议做异地冷备。
多语言AI客服的配置账:显存、带宽、并发怎么估
多语言客服的核心不是“模型多大”,而是“并发多少、语种多少”。一个 7B 级别的模型做 RAG 问答,量化后显存占用约 6~8GB;如果同时服务英语、印尼语、泰语、越南语,建议用多语言能力较好的底座(如 Qwen2.5 或 Llama 3.1 8B),单卡 24GB 显存可支撑 10~20 路并发。个人站长初期日咨询量在 500~2000 条时,一块 RTX 4090 或 A10 级别的 GPU 云实例就够,月成本通常在数千元量级;如果直接上物理 GPU 服务器,月租一般要五位数起,对个人博主不划算。
真正容易被低估的是带宽和存储。多语言客服前端要加载聊天窗口、语音转写、图片识别,单次会话的上下行流量按 1~3MB 估算,100 并发在线时 20M 带宽基本够用;知识库的向量索引和原始文档(PDF、商品页)建议单独挂一块 SSD,50GB 起步,商品 SKU 多的独立站直接上 1T SSD 更省心。
实操步骤可以拆成四步:第一步,在新加坡服务器上装 Ollama 或 vLLM,拉取量化后的多语言模型;第二步,用 LangChain 或 FastGPT 搭 RAG,把商品 FAQ、物流政策、退换货规则切片入库;第三步,前端接 WhatsApp Business API 或网站聊天插件,按语种路由到同一套后端;第四步,加一层审计日志,记录每次问答的输入输出,满足金融级客户的可追溯要求。
选型时要对比的参数清单与常见坑
- 线路:新加坡机房一般分国际带宽和优化回国带宽。面向东南亚本地用户,优先选本地 BGP 国际带宽;如果团队在国内办公,需要确认是否有 CN2 或优化线路,否则后台管理会卡。
- IP 类型:做多语言客服和独立站,原生 IP 对搜索引擎和支付风控更友好;站群需求才考虑多 IP 方案。
- 防御:客服入口容易被刷,DDoS 高防是刚需,至少 10G 起步,视服务商而定。
- 合规:确认机房是否支持数据驻留声明、是否提供访问日志导出,金融级客户通常会要这两样。
- 扩容:GPU 实例能否按小时升配,比一次性买断物理机更适合个人站长试错。
常见坑有三个:一是把模型跑在 8G 内存的轻量云上,量化后仍然 OOM;二是知识库文档没做去重和版本管理,模型答出过期的退换货政策;三是只在新加坡放了一台机器,没有做快照和异地备份,一次误操作就把向量库清空。
选购推荐
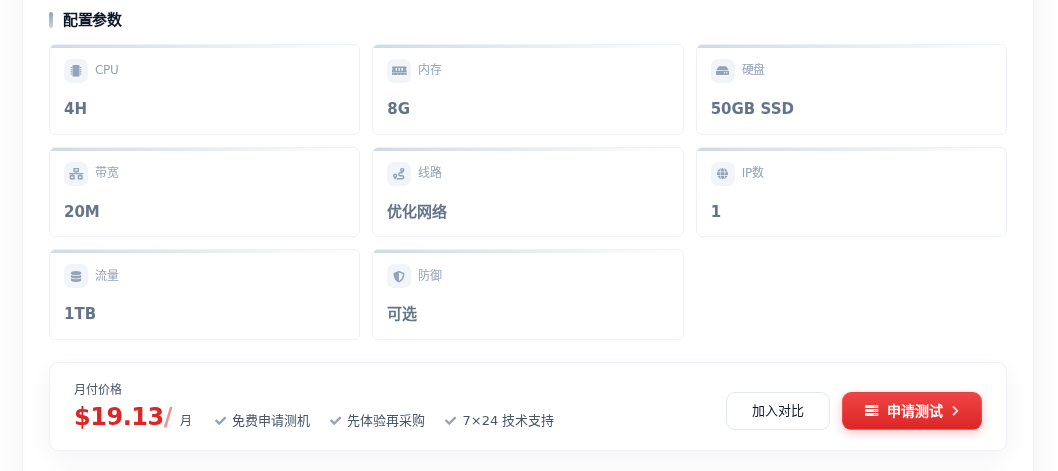
如果处在验证阶段,日咨询量不大、想先把 RAG 跑通,推荐 新加坡大带宽云服务器 ⑮(4H/8G/50GB SSD/20M 带宽,19.13 元/月)。这个配置适合放客服前端、知识库管理后台和轻量向量检索,GPU 推理可以先走按量实例,等并发稳定后再迁到物理机,试错成本低。
如果客服入口已经承载独立站流量、需要扛住促销期并发和 DDoS 骚扰,推荐 新加坡大带宽服务器 IX(E5-2683v4*2/64G/1T SSD/100M 带宽,913.5 元/月)。64G 内存可以同时跑模型服务、向量库和审计日志,100M 带宽在直播客服或语音转写场景下更从容,适合作为东南亚业务总部的长期底座。
决策建议
个人站长和自媒体博主做多语言 AI 客服,不必一上来就追求金融级全套。先用新加坡云服务器把 RAG 和审计日志跑通,确认语种覆盖和并发量级,再把推理层迁到 GPU 物理机或高配大带宽机型。合规上优先确认数据存储位置和日志可导出,这两点比模型参数更影响支付通道和客户的信任。选型时把线路、IP 类型、防御和扩容方式列成清单逐项打勾,比只看价格更少踩坑。